Briser les silos de données : les arguments d’un lakehouse pour l’entreprise
L’article qui accompagne celui-ci décrivait une situation que toute grande organisation reconnaît : six systèmes, chacun détenant un morceau de la vérité, aucun n’étant d’accord avec les autres, et un coûteux dispositif manuel bâti pour masquer l’écart. Ce billet porte sur une architecture qui s’y attaque sans les deux manœuvres qui échouent habituellement — tout arracher pour consolider, ou construire un énième entrepôt périmé. Elle s’appelle data lakehouse, et les arguments en sa faveur relèvent moins de la technologie que du fait de pouvoir, enfin, voir l’organisation dans son ensemble.
L’idée centrale, en termes simples
Un data lakehouse est une couche où toutes vos données peuvent reposer ensemble, en plein détail, dans un format ouvert, interrogeables comme un tout — sans d’abord être extraites des systèmes qui font tourner votre activité et entassées dans un unique système nouveau.
C’est toute l’idée, et le « sans » en est la partie importante. Vous ne consolidez pas les systèmes sources. Ils continuent de fonctionner, de faire leur travail. Ce qui change, c’est que les données de chacun d’eux atterrissent dans un endroit conçu pour les tenir ensemble et vous permettre de les interroger de façon transverse. Les systèmes restent séparés ; les données cessent d’être prisonnières.
Mécaniquement, la donnée réside dans un stockage ouvert et bon marché plutôt que dans une base de données propriétaire. Un format de table ouvert posé par-dessus lui confère la fiabilité qu’offrait autrefois l’entrepôt : des lectures cohérentes, la capacité d’évoluer à mesure que les sources changent, la possibilité de regarder la donnée telle qu’elle était à un instant passé. Et un moteur de requête la lit là où elle se trouve. Rien n’est enfermé dans la boîte d’un fournisseur, parce que la donnée est dans un format ouvert que de nombreux outils savent lire.
Ce qui change quand les données reposent ensemble
Le bénéfice abstrait, c’est « une source unique de vérité ». Les bénéfices concrets sont plus intéressants, et ce sont eux qui justifient réellement l’effort.
Vous pouvez enfin poser des questions à l’échelle de toute l’organisation. Le client dans le CRM, dans le système de facturation et dans la plateforme de service peut être résolu en un seul client, de sorte que « quelle est la relation complète de ce client avec nous » devient une requête au lieu d’un projet. Les questions qui prenaient trois semaines de bricolage de données deviennent traitables en une après-midi.
Les écarts entre systèmes deviennent visibles, et c’est dans les écarts que vit l’argent. La fuite de revenus se cache dans la jointure entre ce qui a été livré et ce qui a été facturé ; la fraude se cache dans la jointure entre deux systèmes qui ne voient chacun que la moitié du signal ; un risque de conformité se cache dans le fait qu’aucun système ne détient la totalité de la preuve. Quand les données reposent ensemble, les jointures deviennent inspectables. Vous pouvez confronter ce que dit un système à ce que dit un autre, en continu, au lieu d’une fois par trimestre dans une réunion.
Vos analystes récupèrent leur temps. Quand l’image est déjà assemblée, vos meilleurs éléments passent leurs heures à l’analyser plutôt qu’à la construire. Ce basculement (de l’assemblage des données à leur exploitation) est souvent le retour pratique le plus important, et c’est celui qui est le plus difficile à mettre sur une diapositive.
Et l’historique devient un actif plutôt qu’une archive. Parce que le stockage est bon marché et ouvert, vous pouvez vous permettre de garder des années de détail interrogeables, et non remisées et de fait perdues. Les motifs dans le temps (chez les clients, dans les opérations, dans le risque) deviennent visibles parce que l’historique est réellement atteignable.
Pourquoi pas simplement consolider, ou construire un entrepôt
Il vaut la peine d’être direct sur les raisons pour lesquelles cela l’emporte sur les deux réflexes habituels, car un acheteur en entreprise a vu les deux et s’y est brûlé.
La consolidation est une migration pluriannuelle à haut risque qui lutte contre une marée qu’elle ne peut vaincre, car de nouveaux besoins ne cessent d’engendrer de nouveaux systèmes. Le lakehouse ne vous demande de rien retirer. Les systèmes sources restent ; les données se rejoignent. Vous obtenez la vue unique sans l’opération à cœur ouvert.
L’entrepôt classique recopie tout dans un magasin unique, coûteux, rigide, souvent périmé, et devient fréquemment un système de plus, avec une version de plus des chiffres. Le lakehouse conserve la souplesse et le stockage bon marché d’un data lake mais rétablit la fiabilité qu’avait l’entrepôt : vous n’échangez donc pas la cohérence contre le coût ou la fraîcheur. Et parce qu’il interroge la donnée dans des formats ouverts, il contourne la dépendance qui fait d’un entrepôt propriétaire une décision difficile à inverser.
La propriété qui compte le plus dans la durée
Il y a un bénéfice qui paraît abstrait jusqu’au jour où il ne l’est plus : parce que la donnée réside dans des formats ouverts sur un stockage que vous contrôlez, elle reste la vôtre. Tout moteur capable de lire le format ouvert peut la lire, y compris des outils avec lesquels le fournisseur d’origine n’a rien à voir. Il n’y a pas de processus d’export pour récupérer vos propres données, parce qu’elles n’ont jamais été enfermées.
Le test est une question à poser à toute décision de plateforme de données : si nous cessons de travailler avec ce fournisseur dans trois ans, qu’advient-il de nos données ? Si la réponse suppose un export, un format propriétaire ou une prestation de services pour récupérer vos propres informations, c’est que vous en louiez l’accès. Avec un lakehouse bâti sur des fondations ouvertes, la réponse est « rien ne se passe, elles sont dans des tables ouvertes, sur notre stockage, et nous continuons de les interroger ». Ce n’est pas une fonctionnalité que l’on fait briller en démo. C’est ce dont vous êtes reconnaissant la troisième fois qu’un contrat arrive à renouvellement.
Comment Synaptique s’y prend
C’est l’architecture que construit Synaptique ; il vaut donc la peine d’être concret plutôt qu’abstrait à son sujet.
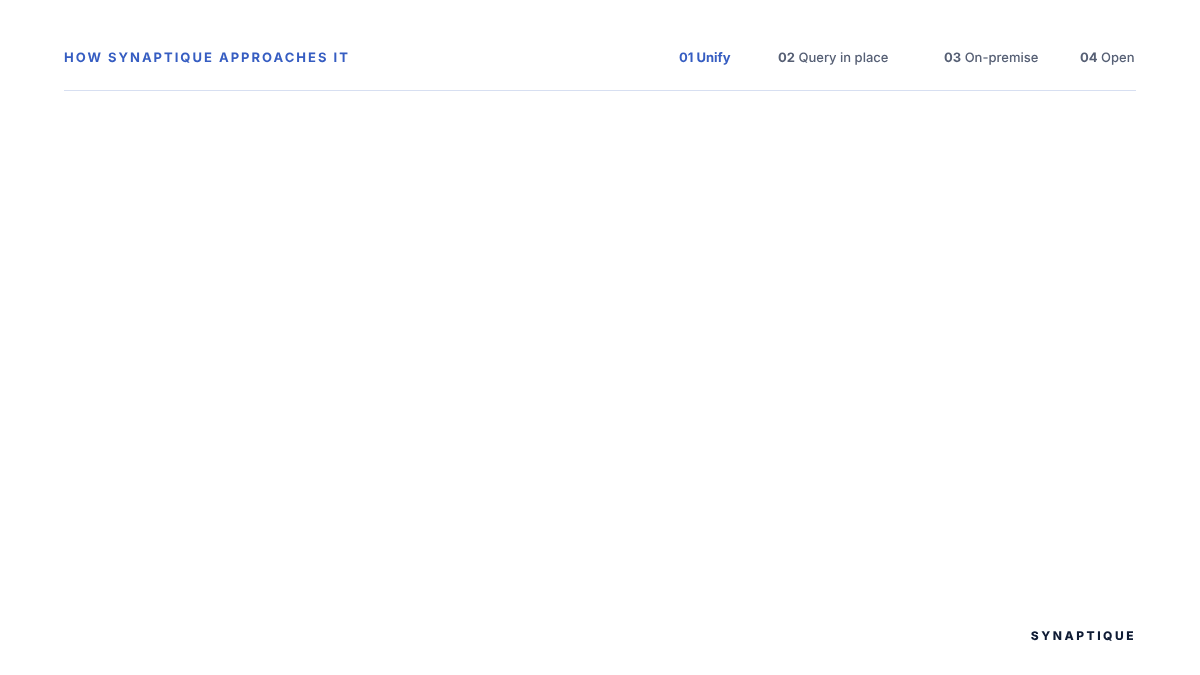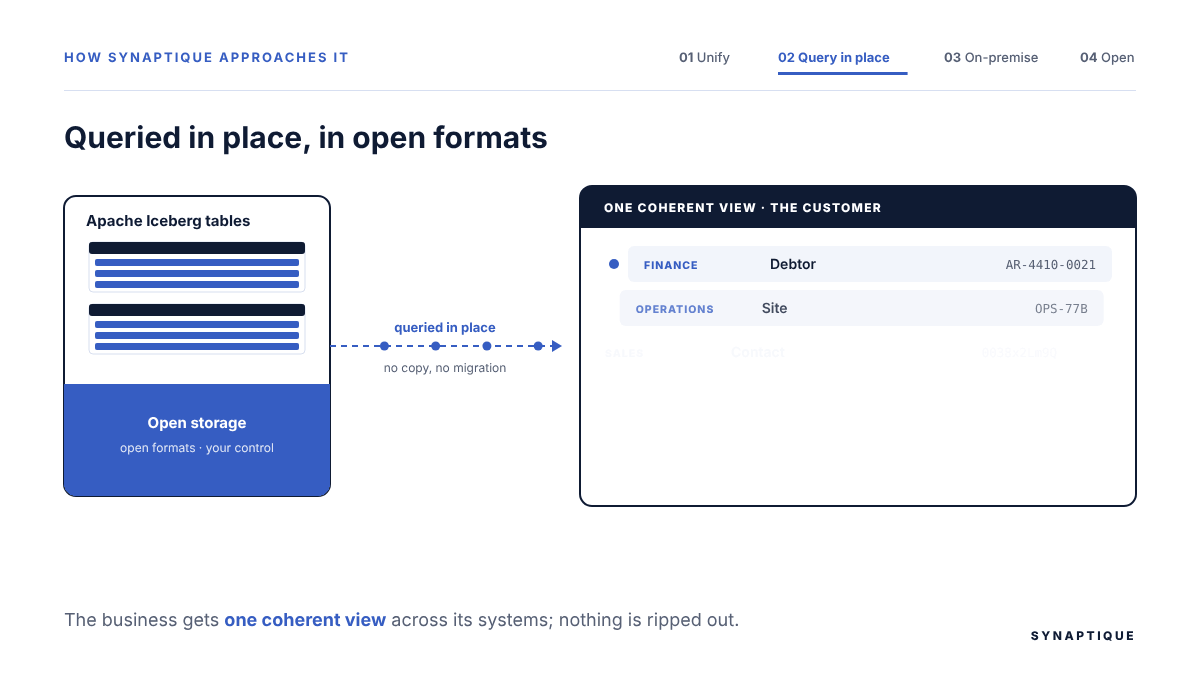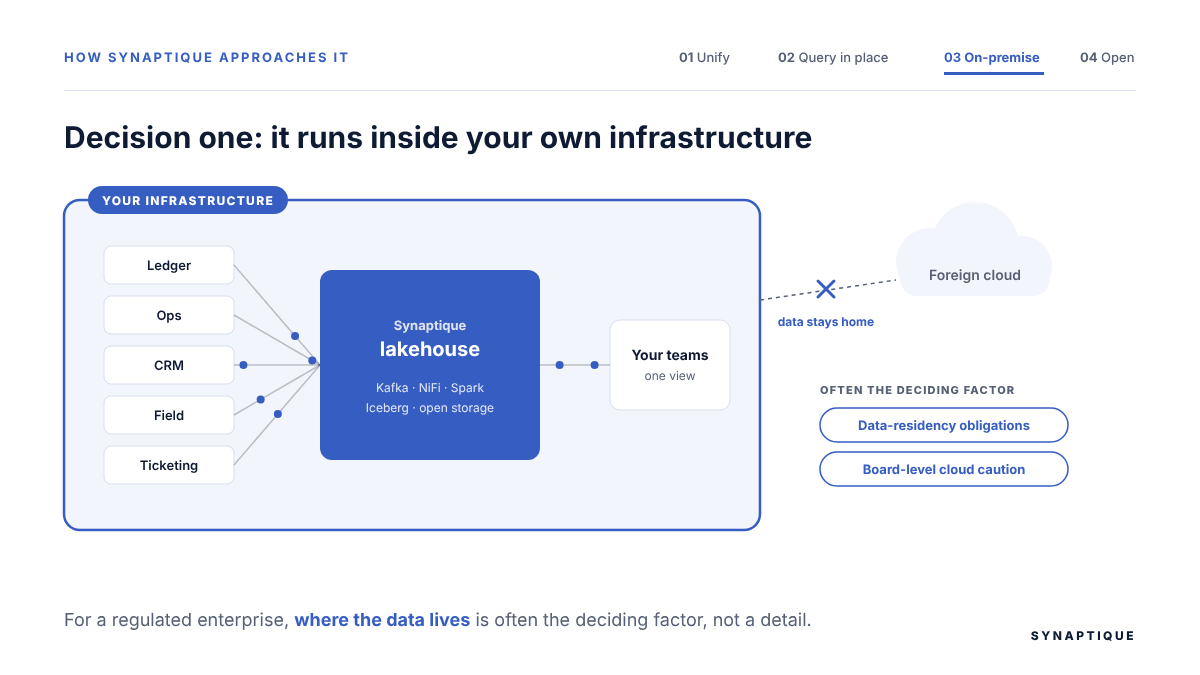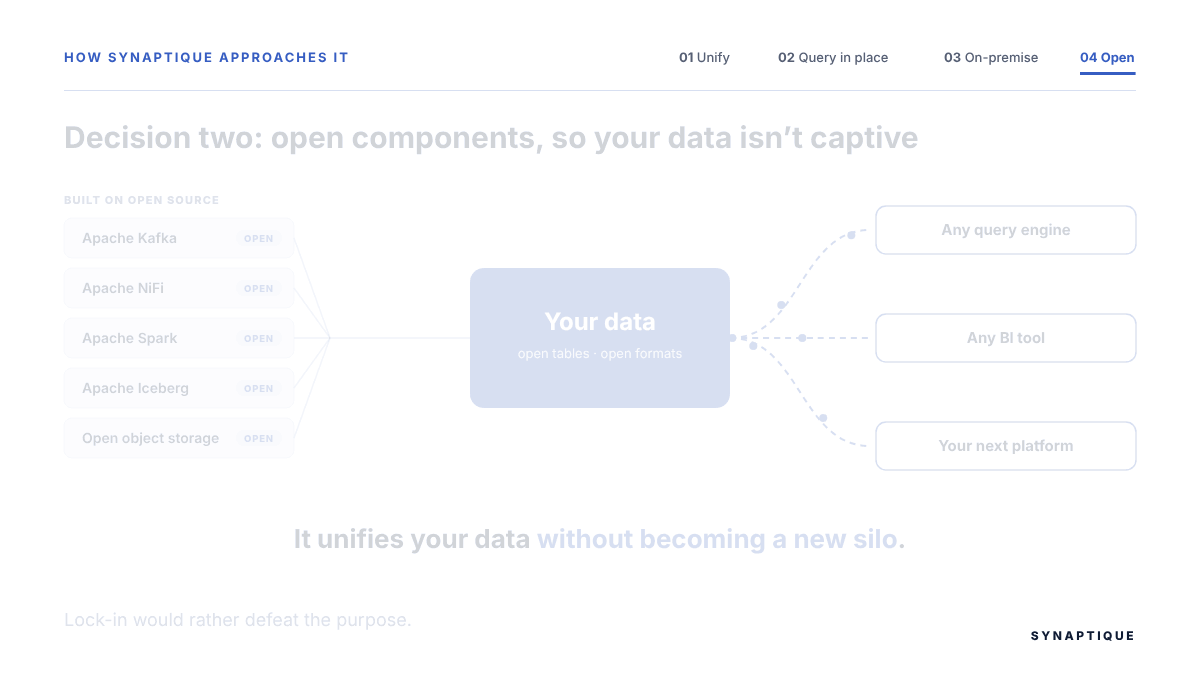
Synaptique fournit une plateforme data lakehouse ouverte qui permet à une organisation d’unifier les données de ses systèmes sans programme de consolidation. Les données des systèmes sources sont réunies (via Apache Kafka et Apache NiFi pour l’ingestion en streaming et en batch, Apache Spark pour le chargement de l’historique) dans des tables Apache Iceberg sur un stockage ouvert que l’organisation contrôle, ou sur un stockage cloud lorsque c’est préférable. Elles sont interrogées sur place, dans des formats ouverts, de sorte que l’entreprise obtient une vue cohérente à travers ses systèmes tandis que les systèmes eux-mêmes continuent de fonctionner.
Deux choix comptent tout particulièrement pour une entreprise grande ou régulée. La plateforme peut fonctionner sur site, dans votre propre infrastructure, ce qui, pour les organisations soumises à des obligations de résidence des données ou simplement prudentes au niveau du conseil d’administration face au cloud étranger, est souvent le facteur décisif plutôt qu’un détail. Et parce qu’elle est bâtie sur des composants ouverts, vos données ne sont pas captives : la plateforme unifie vos données sans devenir un nouveau silo dans lequel vous seriez enfermé, ce qui irait plutôt à l’encontre du but recherché.
Ce qu’il ne règle pas, honnêtement
Un lakehouse ne répare pas de mauvaises données. Si un système source détient des enregistrements faux ou incomplets, les unifier produit une vue complète et confiante d’une image fausse, ce qui peut être pire que de savoir qu’il vous manque quelque chose. La qualité des données au point d’ingestion est le premier travail, pas une réflexion après coup.
Il ne supprime pas la nécessité de décider ce qu’est la vérité partagée. Résoudre le client présent dans six systèmes en un seul client suppose de s’accorder sur ce qui compte comme étant le même client, une décision métier, non technique, et souvent une conversation plus ardue que l’ingénierie. L’architecture rend la vue unifiée possible ; il revient encore à des humains de la définir.
Et ce n’est pas un projet que l’on termine. Les sources changent, de nouveaux systèmes apparaissent, et le lakehouse les ingère aussi, ce qui est précisément l’intérêt, puisqu’il est conçu pour absorber le système suivant plutôt que pour être remplacé par lui. Mais c’est une capacité que l’on exploite, pas une boîte que l’on installe avant de passer à autre chose.
Par où commencer
Pas par un programme à l’échelle de toute la plateforme. Choisissez une question à laquelle vous ne pouvez pas répondre proprement aujourd’hui parce que la donnée est éclatée (la relation complète d’un seul client, le coût réel de bout en bout d’un processus, la réconciliation entre deux systèmes qui ne concordent jamais tout à fait) et unifiez seulement les données que cette question requiert. Une question, les systèmes qu’elle touche, une réponse réelle.
Ce démarrage borné fait deux choses : il livre quelque chose d’utile rapidement, et il prouve l’approche sur vos propres données avant que vous ne vous engagiez davantage. La vue à l’échelle de l’organisation se construit une question traitable à la fois, pas d’un grand coup.
Synaptique met en œuvre exactement ce type de démarrage cadré (une question transverse, unifiée sur vos propres données, résolue) comme porte d’entrée vers la plateforme plus large. S’il existe une question que vos silos ne vous laissent pas résoudre, c’est le moment d’en parler. Réservez un appel dès maintenant.